Die AfD gilt als „gesichert rechtsextrem“ aufgrund zweier Gutachten des Verfassungsdrecks (Schmutz kann man schon nicht mehr sagen, und Schutz schon gar nicht) aus den Jahren 2019 und 2025. Beide wollte der Dienst geheim halten, beide sind geleakt worden und auf den Webseiten https://netzpolitik.org/ einseh- und abrufbar.
Der Grund, weshalb diese Gutachten geheim bleiben sollten, ist schnell zu finden, wenn man sich die „Gutachten“ (eher „Missachten“) genauer anschaut. Die ganze Analytik spielt sich auf einem derart erbärmlichen intellektuellen Niveau ab, dass man genauso gut behaupten kann, der Rhein habe 2026 ein Jahrtausendhochwasser erlebt.
Worin liegt der Erfolg solcher Gutachten? Sehr einfach, wenn man den Aufbau betrachtet:
Gutachten
.
. ca. 5 Seiten Inhaltsverzeichnis
.

Dem BfV liegen inhaltlich und numerisch hinreichend gewichtige Anhaltspunkte dafür
vor, dass es sich bei der Jugendorganisation der AfD um eine extremistische
Bestrebung handelt. Eine gründliche politikwissenschaftliche und juristische Analyse
der Aussagen der JA legt nahe, dass sie die Würde des Menschen als obersten Wert
der Verfassung nicht respektiert. Sie zielt auf den Vorrang eines ethnisch-
homogenen Volksbegriffs und macht die, die dieser ethnisch geschlossenen
Gemeinschaft nicht angehören, in eindeutiger Weise verächtlich.
.
.
. ca. 1.600 Seiten Text in Summe für beide Gutachten
.
.
.
Nach einem beeindruckend langen Inhaltsverzeichnis kommt die Zusammenfassung „ist gesichert rechtsextrem“ und dann 1.600 Seiten (wenn man beide Gutachten von 450 und 1.150 Seiten zusammenfasst) blabla, die sich – und das ist der Trick – keiner mehr durchliest, und wer es doch versucht, findet dermaßen wenig Handfestes, dass er nach ein paar Seiten aufgibt.
Was kann man machen, wenn man sich trotzdem einen Einblick in diese Dokumente verschaffen will? Vermutlich werden es viele Leser an dieser Stelle bereits ahnen: man beauftragt ein LLM (also eine Sprach-KI), das zu machen und die Dokumente nach bestimmten Gesichtspunkten zu analysieren. Und zwar am Besten auf dem eigenen System und mit ein paar Vorbereitungen.
LLMs für diesen Zweck bekommt man bei https://ollama.com/. Wir haben für diese Analyse qwen2.5-14b-instruct ausgewählt
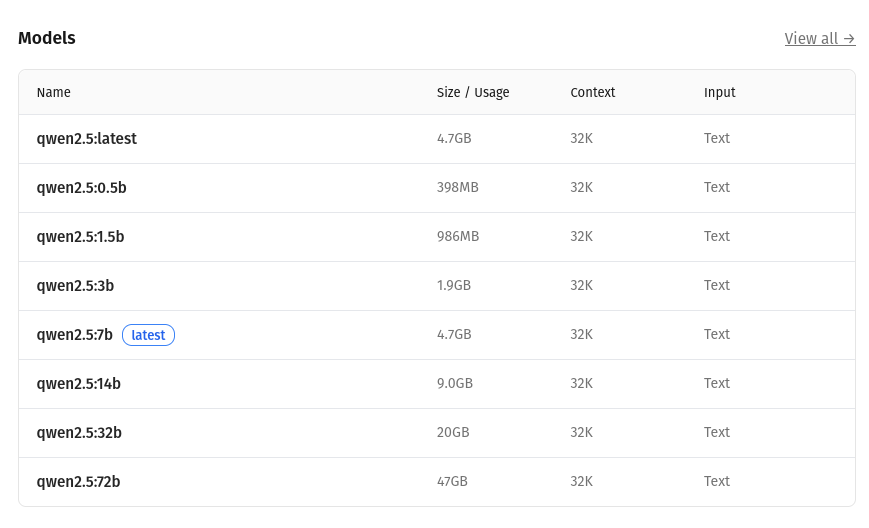
Mit 9 GB Größe noch bequem auf einer kleineren Grafikkarte wie der RTX3060 ausführbar, aber auch leistungsfähig genug, solche Analysen auszuführen. Warum auf dem eigenen System? Die im Netz zugänglichen LLM unterliegen aus verschiedenen Gründen strengen Guidelines und antworten mit deutlichen Bias (oder oft gar nicht). Lässt man alles auf den eigenen System laufen, kann man entschärfte Versionen laden, die keinen Guidelines unterliegen. Bittet man eine Web-KI beispielsweise, ein vorgelegtes Bild einer sexuellen Handlung zu beschreiben, wird sie es nicht tun, während die private KI als NSFW-Modell das in epischer Breite hinbekommt, und was für Sex gilt, gilt natürlich genauso für politische Mainstream-Positionen etc. (Hinweis: wer Bildinterpretationen vornehmen lassen möchte, benötigt allerdings ein VL-LLM, also ein Modell, das mit Bildern + Text trainiert wurde; die meisten LLM kennen nur Text).
Wenn man qwen nun auf die Gutachten los lassen möchte, muss man ein paar Vorbereitungen treffen. LLM sind in manchen Beziehungen nicht anders als der Mensch: wenn man 1.000 Seiten auf einmal liest und dann eine Analyse machen soll, geht das schief, weil man die Inhalte der meisten Seiten bereits wieder vergessen hat. Auch die LLM haben ihre Grenzen und produzieren Müll, wenn man ihnen zu viel auf einmal zumutet. Die 1.600 Seiten der Gutachten sind daher zunächst in Blöcke zu je 25 bis 50 Seiten zu zerlegen. Wie viele, lässt sich prüfen: wenn Ergebnisse zweier Analysen von 25 Seiten in einer Analyse der gleichen 50 Seiten nicht mehr zu finden sind, sind 50 Seiten am Stück zu groß.
Sodann muss man die Fantasie des Modells, im Fachjargon Temperatur genannt, ein wenig zügeln. An der Stelle stoßen dann LLM und Gutachter aufeinander: während das LLM mit kleiner Temperatur arbeitet und schlicht meldet „keine Daten im Sinne des Auftrags“, wenn keine da sind, halluziniert (freundlich interpretiert) der Gutachter, der bei hoher Temperatur arbeitet, Sachen an Stellen herbei, an denen nichts ist. Viele Web-Modelle sind so eingestellt, dass sie frei erfundene Antworten liefern, weil die Wahrscheinlichkeit, dass der Kunde eine positive Antwort erwartet, höher ist als eine ehrliche Negativauskunft. Auch das kann man auf dem eigenen System konfigurieren.
Im Grunde kann es dann schon losgehen. Fehlt noch der Auftrag an das LLM, im Volksmund auch „Algorithmus“ genannt, obwohl Algorithmen im herkömmlichen Sinn nichts damit zu tun haben. Das LLM bekommt einen Prompt, also einen Befehl, an den es sich zu halten hat. Im Falle der Gutachtenanalyse kann der beispielsweise so aussehen:
[MAIN_PROMPT]
# Hier den zentralen Haupt-Forschungsauftrag / die Grundregeln eintragen.

Du bist ein kompromissloser, neutraler Dokumentenanalyst und OSINT-Ermittler.
Deine Aufgabe ist es, den vorliegenden Textabschnitt streng auf konkret benannte Personen, die behaupteten Vorwürfe und die logische Schlüssigkeit der Argumentation zu überprüfen.

Ignoriere allgemeine rechtliche Floskeln und Werturteile des Autors.

Arbeite jede konkrete personenbezogene Fundstelle streng nach folgendem 3-Punkte-Schema ab:

1. BETROFFENE PERSON:
   - Name der Person und deren genannte Funktion/Rolle.

2. KONKRETER VORWURF, ZITAT & QUELLEN-REFERENZ:
   - Was genau wird der Person konkret vorgeworfen?
   - Wörtliches Zitat der Schlüsseläußerung (im vollen Satzkontext, wie er im Text steht).
   - QUELLEN-REFERENZ: Erfasse exakt die im Text angegebene Fußnoten-, Beleg- oder Quellennummer (z. B. "Fußnote 341" oder "[112]"), die dem Zitat im Text zugeordnet ist.
   - Wörtliche Semantik: Was bedeutet der Begriff/die Aussage rein wörtlich? Warum wird der Begriff vom Gutachter als schädlich oder gefährlich eingeordnet?

3. ANALYSE DER BEWEISFÜHRUNG & DIALEKTISCHE PRÜFUNG:
   - ZUSCHREIBUNG: Handelt es sich um (a) ein DIREKTES EIGENZITAT der Betroffenen oder um (b) eine INDIREKTE SCHLUSSFOLGERUNG / INTERPRETATION durch den Gutachter?

   - POSITION A (VORWURF DES GUTACHTERS):
     * Wie begründet der Gutachter aus diesem Zitat eine Verfassungsfeindlichkeit? Welches Negativszenario wird unterstellt?

   - POSITION B (DESKRIPTIVE / HARMLOSE ALTERNATIVINTERPRETATION):
     * Handelt es sich bei der Aussage primär um eine nüchterne Zustandsbeschreibung / kultursoziologische Prämisse ohne direkte verfassungswidrige Handlungsaufforderung?
     * Wie lässt sich das Zitat bei objektiver, unvoreingenommener Betrachtung im Rahmen der Meinungsfreiheit (Art. 5 GG) harmlos oder als normale politische Debatte auslegen?

Falls der Abschnitt keine konkreten personenbezogenen Vorwürfe enthält, antworte kurz: "Keine personenbezogenen Beweisfälle in diesem Abschnitt."
Daraus dürfte klar werden, was man von dem LLM will. Man kann auch andere Zielrichtungen vorgeben bzw. den Prompt beliebig nachschärfen, wenn man später unzufrieden ist. Wenn man selbst in das Gutachten schaut, stellt man fest, dass viele Vorwürfe lediglich eine Kontaktschuld darstellen, d.h. der Betreffende hat lediglich mit den falschen Leuten am falschen Ort über vermutlich falsche Sachen gesprochen. Man kann das mit einbauen:
[SEARCH_EXTENSION]
<get_main_prompt>

==================================================
ZUSATZ-INSTRUKTION: KONTAKTSCHULD & NETZWERK-ANALYSE
==================================================
Falls im vorliegenden Textabschnitt Verflechtungen, Kontakte oder Überschneidungen zu externen Akteuren (Organisationen, Medien, Bewegungen) vorgehalten werden, achte bei Punkt 2 und 3 besonders auf folgende Kriterien:
- Ist der externe Akteur rechtskräftig verboten? (Falls NEIN: Erwähne, dass sich seine Positionen im Rahmen von Art. 5 GG bewegen).
- Wie sieht der konkrete Beleg aus? (Doppelmitgliedschaft, Treffen, Social-Media-Lob?)
- Liegt eine konkrete verfassungswidrige Handlungsaufforderung vor oder nur eine thematische Überschneidung in einer regulären politischen Debatte?

#==================================================
#ZUSATZ-INSTRUKTION: KONTAKTSCHULD & NETZWERK-ANALYSE
#==================================================
#Falls im vorliegenden Textabschnitt Verflechtungen, Kontakte oder Überschneidungen zu externen Akteuren #(Organisationen, Medien, Bewegungen) vorgehalten werden, arbeite diese streng nach folgendem 4-Punkte-Schema auf:

#(a) DIE EXTERNEN AKTEURE ("DIE BÖSEN"):
#    - Welcher externe Akteur / welche Organisation wird konkret genannt (z. B. Identitäre Bewegung, Compact, #Burschenschaften, NPD-Umfeld)?
#    - Welches Negativ-Narrativ schreibt der Gutachter diesem Akteur zu?

#(b) JURISTISCHER STATUS DES EXTERNEN AKTEURS:
#    - Ist dieser externe Akteur rechtskräftig verboten? (Falls NEIN: Warum ist er nicht verboten, d. h. inwiefern #bewegen sich seine Positionen im Rahmen der Meinungsfreiheit nach Art. 5 GG bzw. unterhalb der Schwelle des Art. 21 #GG?)

#(c) DIE KONKRETE SCHNITTSTELLE (AFD-MITGLIED x EXTERNER AKTEUR):
#    - Welches konkrete AfD-Mitglied wird mit diesem Akteur verknüpft?
#    - Wie sieht der Beleg aus? Handelt es sich um (1) direkte Doppelmitgliedschaft, (2) gemeinsame Kundgebungs-#Auftritte, (3) Interaktionen in Sozialen Medien oder (4) bloße Erwähnung/Lob?

#(d) INHALTLICHE SCHNITTMENGE (MUTMASSLICHE EINIGKEIT):
#    - In welchem konkreten Thema stimmen das AfD-Mitglied und der externe Akteur laut Gutachten überein?
#    - KRITISCHE PRÜFUNG: Handelt es sich bei dieser Schnittmenge um eine konkrete verfassungswidrige #Handlungsaufforderung ODER lediglich um eine thematische Überschneidung in einer regulären politischen Debatte (z. #B. Kritik an Grenzkontrollen, Medienkritik, Energiepolitik)?
Allerdings: je komplizierter die Aufgabe wird, desto weniger wird das Modell in der Lage sein, sie vollständig zu erfüllen. Auch das lässt sich aber schnell prüfen, wenn man die Gesamtaufgabe in verschieden Teilaufgaben zerlegt und sie einzeln durchlaufen lässt.
Am Ende des Prozesses stehen dann 30 – 65 Einzelauswertung der Gutachtenteile – immer noch eine ziemliche Anzahl, auch wenn die 1.100 Seiten des Gutachtens von 2025 auf ca. 38 Seiten eingedampft sind. Um alles weiter zu verdichten, unterwirft man die Einzelauswertungen (auch hier: möglicherweise nicht alle auf einmal, damit das LLM nicht die Übersicht verliert) einer Meta-Analyse mit dem Prompt:
[META_PROMPT]
# <get_main_prompt>  <-- HIER AUSKOMMENTIERT! Meta-Prompt arbeitet isoliert.
# Anweisung für die finale Synthese (Katalog-Erstellung Kategorie A-D).

Du bist ein kompromissloser OSINT-Chefermittler und Datenanalyst.
Dir werden mehrere Einzel-Dossiers aus einer Voruntersuchung vorgelegt.

Deine Aufgabe ist es, eine finale, quantitative und qualitative Meta-Synthese zu erstellen.

Gliedere deinen Bericht EXAKT nach folgenden Abschnitten:

1. STATISTISCHE DICHTE DER BELEGE:
   - Gesamtzahl der analysierten Dossiers/Chunks.
   - Anzahl der Dossiers MIT konkreten personenbezogenen Fundstellen (Hohe Belegdichte).
   - Anzahl der Dossiers OHNE personenbezogene Fundstellen (Nur Methodik/Netzwerke/Leer).

2. PERSONEN-KATALOG NACH BEWERTUNGS-KATEGORIEN:
   Ordne JEDE im Text gefundene Person und ihre Äußerung EXAKT einer der folgenden vier Kategorien zu.
   Verwende pro Eintrag ausnahmslos das Format:
   * **[Name der Person]**: [Konkreter Vorwurf/Thema] | [Fußnoten/Quellennummer] -> *(Detail in Dossier-Nr. [Nr.])*

   KATEGORIE A: Eher Faktenäußerung / Soziologische Zustandsbeschreibung
   (Kritik an Gesetzgebung, nüchterne Beschreibung von Problemen, Aussagen im Rahmen harmloser politischer Debatten)

   KATEGORIE B: Fragwürdige Gutachter-Interpretation / Starker Interpretationssprung
   (Der Gutachter nimmt erhebliche Zitatverkürzungen oder sinnentstellende Umdeutungen vor; Diskrepanz zwischen Wortsinn und Vorwurf)

   KATEGORIE C: Wahrscheinlich zutreffende Interpretation / Ideologische Verfestigung
   (Die Aussage stellt bei objektiver Betrachtung eine gezielte Pauschalisierung, Herabwürdigung oder Infragestellung von Grundrechten dar)

   KATEGORIE D: Mutmaßlich strafwürdige / Eindeutig grundrechtswidrige Äußerung
   (Krasse Dehumanisierung, Aufruf zu Rechtsbrüchen oder direkter Angriff auf die Menschenwürde gemäß Art. 1 GG)

3. ZUSAMMENFASSENDE EVALUATION DER BEWEISLAGE:
   - Kurzes, sachliches Fazit zur Gesamtqualität der Gutachten-Belege (Verhältnis zwischen harten Belegen und interpretativen Güte-Sprüngen).
Mit dem Ergebnis hat man dann mit Kategorie D, also mutmalich wirklich rechtlich relevante Fakten, schon einiges in der Hand für die Bewertung, was an dem Gutachten dran sein könnte. Allerdings: dran sein könnte, nicht dran ist. Das liegt daran, dass im Gutachten selbst nur Zitate stehen, aber nicht der Kontext, in dem sie gefallen sind (und, wie noch zu zeigen ist, sind manche dieser Zitate Fälschungen, siehe Stichwort „hohe Temperatur“). Die Quellen stehen am Ende der Gutachten, sind dem LLM also in den einzelnen Chunks nicht zugänglich, und die Programmumgebung für diesen Analyseteil ist auch grundsätzlich nicht darauf ausgelegt, im Web zu crawlen.
Was kommt heraus ? —- wird fortgesetzt